Ich modelliere einen Crawler für das öffentliche deutsche Web. Rund 12.000 Quellen: Bundestag, Bundesrat, Behörden, Kommunen, die offiziellen Seiten von Amtsträgern. Nicht ihre privaten Accounts und keine allgemeinen Medien; diese Grenze wird auf Host-Ebene gezogen und nirgends sonst. Die Überschlagsrechnung sagt 200 Millionen URLs in fünf Jahren, im Schnitt etwas über 100.000 am Tag.
Fünf Systeme. Drei erzeugen Daten, eines steht davor, eines ist der Dienst, den Menschen nutzen.
Der Spider erzeugt genau eine Sache: einen URL-Index als Datensatz. Ein Append-only-Eintrag pro URL, mit Host, zuerst gesehen, letztem Abruf, Status, Content-Hash, ausgehenden Links. Die Rohbytes landen in einem Object Store, mit dem Hash als Schlüssel. Der Spider weiß nicht, was eine Pressemitteilung ist.
Der Indexer erzeugt genau eine Sache: einen Inhaltsdatensatz. Und zwar nur für Inhaltsseiten. Ein Seitentyp-Klassifikator läuft vor der Extraktion und entscheidet, ob eine URL eine Drucksache, eine Bekanntmachung, eine Ratsvorlage, eine Rede, ein PDF ist, oder eine Übersichtsliste, ein Kalender, eine Suchergebnisseite, ein Login-Formular. Die zweite Gruppe wird nie extrahiert, sie bekommt nur ein Flag im URL-Index. Der URL-Index kennt also alle 200 Millionen, der Inhaltsdatensatz nur den Teil davon, den jemand tatsächlich lesen würde.
Das Archiv nimmt dasselbe „abgerufen”-Ereignis wie der Indexer und speichert eine neue Version, sobald sich der Hash geändert hat. Eigenes System, eigener Speicher, der Klassifikator ist ihm egal.
Zwischen diesen Datensätzen und dem Dienst sitzt eine Suchmaschine. Langweiliger Name, mit Absicht. Sie nimmt den Inhaltsdatensatz und den URL-Index inkrementell auf, baut ihren eigenen Index (heute OpenSearch, morgen was auch immer), hält eine abfragbare Projektion des URL-Index und bietet genau eine API an: search_content, get_document, search_urls, source_info. Hybride Suche, Facetten, Stichtagsabfragen. Nichts auf der Seite des Dienstes hat einen Connection-String zu irgendetwas, das der Pipeline gehört.
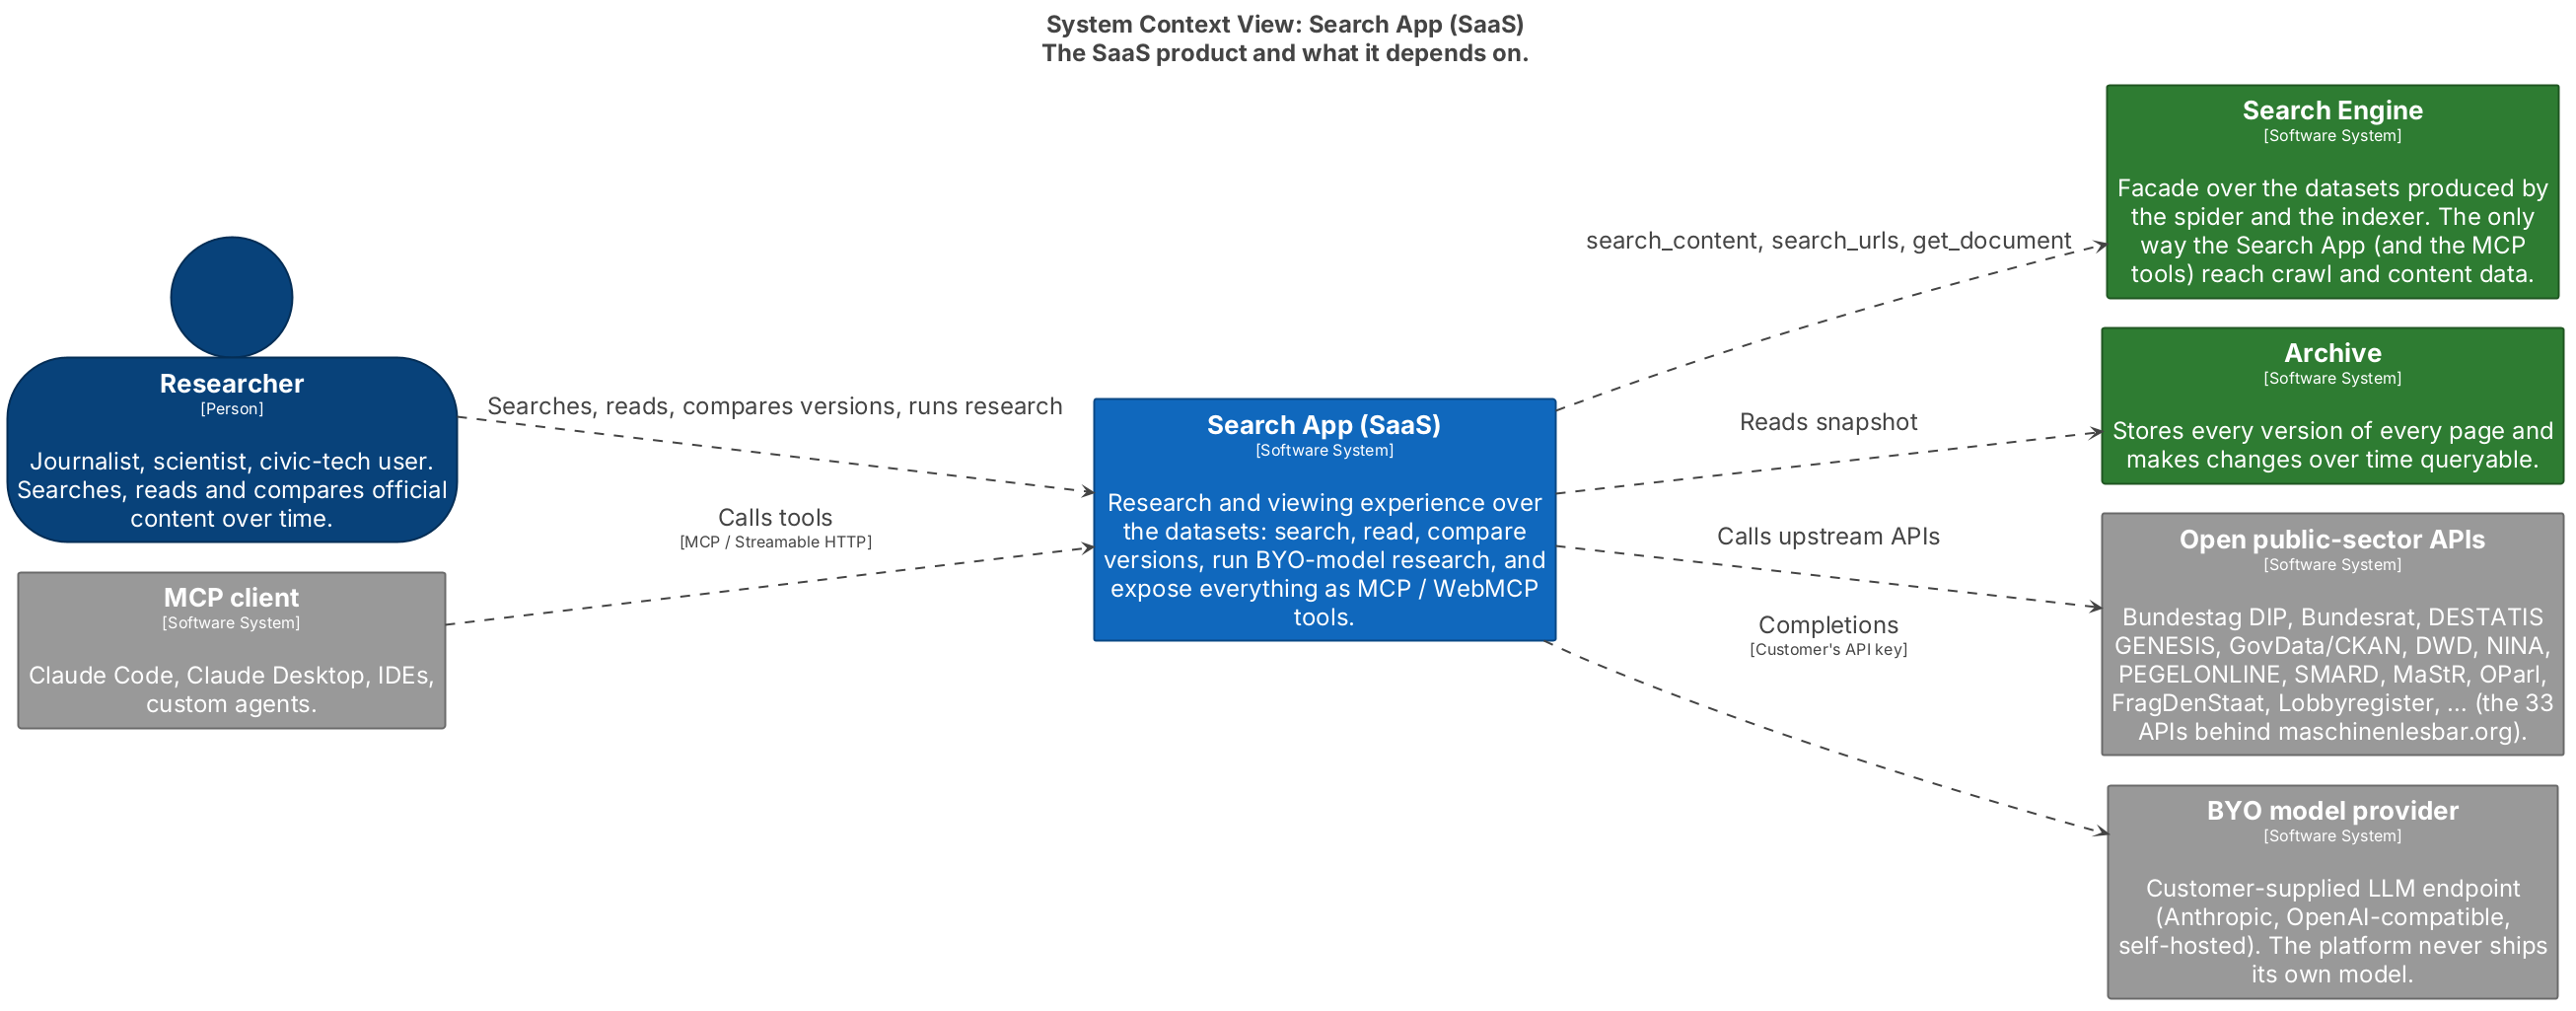
Der Dienst selbst ist zum Recherchieren und Ansehen da. Eine Web-Oberfläche, ein WebMCP-Endpunkt für Agenten im Browser, ein entfernter MCP-Server und ein Recherche-Agent, der mit dem eigenen Modell der Kundschaft läuft (bring your own, wir liefern keins mit). Der MCP-Server trägt die 33 Plugins von maschinenlesbar.org, als MCP-Tools portiert und nach Bereichen gruppiert (Parlament und Transparenz, Statistik, Warnungen, Energie, Arbeit, ein Nachrichten-Tool, das nur Tool ist, die Tagesschau wird nicht gecrawlt), dazu eine Handvoll eigener Tools über unsere eigenen Daten. Die eigenen Tools sind eine dünne Hülle um die Fassade. Ist die Fassade gut, sind die Tools gut.
PS: Der Viewer greift noch direkt auf das Archiv zu. list_versions und diff_versions wandern als Nächstes vermutlich hinter dieselbe API.